跨物种比较单细胞转录组同源基因如何整合
Song, Y., Miao, Z., Brazma, A. et al. Benchmarking strategies for cross-species integration of single-cell RNA sequencing data. Nat Commun14, 6495 (2023). https://doi.org/10.1038/s41467-023-41855-w
Nature Communications 文章:Song et al., 2023,Benchmarking strategies for cross-species integration of single-cell RNA sequencing data。这篇文章的价值在于,它不是单独比较整合算法,而是同时比较了同源基因映射策略 × 单细胞整合算法,并且评估整合后是否既能消除物种带来的技术差异,又能保留真实的细胞生物学差异。
一、先给结论:我会怎样选择?
如果你的目标是常规跨物种 scRNA-seq 整合,我建议把下面这套方案作为首选基线:
推荐的默认方案
数据预处理: 各物种分别进行细胞质量控制、去除低质量细胞和 doublets,并统一细胞类型注释粒度。
同源基因: 先使用 Ensembl 获取一对一 ortholog,建立共同 feature 空间。
整合方法: 优先测试 scVI;如果有可信的细胞类型标签,同时测试 scANVI;再以 Seurat v4 CCA/RPCA 作为对照。
评价标准: 同时评估物种混合程度、细胞类型结构保留程度和细胞类型标签迁移表现,不能只看 UMAP。
这与论文对近缘物种的推荐基本一致。若物种较远、同源注释困难,或分析整个生物体的细胞图谱,则需要改变策略。
不过,必须强调:这篇论文没有证明某一个算法在所有物种、组织和数据集上绝对最好。 它的结论是按分析场景选择方法,而不是给所有任务一个统一冠军。
二、论文中具体怎么处理数据?
这篇文章的分析框架叫 BENGAL。作者比较了 28 种同源基因映射与整合算法组合,并从物种混合、细胞生物学特征保留和细胞类型注释迁移等方面评估结果。
1. 预处理:先保证不同物种的数据可以公平比较
作者明确指出,质量控制和细胞本体注释整理需要在运行整合流程之前完成,不属于整合算法本身。
建议按以下步骤处理:
去除低质量细胞、潜在 doublets,以及线粒体基因比例异常高的细胞。
检查每个物种的细胞类型注释,尽可能统一到可比较的粒度。
保留每个细胞的物种、样本和批次信息。
使用原始基因计数矩阵作为后续 BENGAL 同源映射及整合流程的输入。
特别值得注意的是:不要因为一个物种的细胞注释更细,就直接把另一个物种较粗的标签强行细分。 作者使用 scOntoMatch 帮助对齐不同数据集的细胞类型层级。
2. 同源基因映射:论文实际比较了三种策略
O2O:只保留一对一同源基因
只保留物种间一一对应的 ortholog,映射到共同 feature 空间。这种方式清晰、稳健,适合作为基线。
适合:近缘物种、希望优先保证映射准确性。
HE:一对一 + 高表达同源基因
Higher average expression
在一对一同源基因之外,对一对多或多对多同源关系,按较高的平均表达量选择对应基因。
目的:在一定程度上保留一对一映射丢失的基因表达信息。
SH:一对一 + 高同源置信度基因
Stronger homology confidence
在一对一同源基因之外,按更强的同源关系置信度选择额外对应基因。
目的:尽可能保留更多基因,同时优先考虑同源关系的可靠性。
这三种策略是论文直接比较的核心映射方式。作者发现,对于具有较多一对多和多对多同源关系的远缘物种,适当纳入这些额外同源基因可能改善整合结果。不过,这不等于所有数据集都应该使用 HE 或 SH。
还有一个重要细节:LIGER UINMF 能够处理未共享的 feature,因此在这一方法中,并不是所有基因都必须被强制映射到共同同源基因集合。
3. 统一矩阵:先拼接 raw counts,再进行整合
作者将映射后的不同物种 raw count 矩阵按细胞方向拼接,再输入不同整合算法。
对于共同 feature 集合,文章还采用了批次感知的高变基因选择:按整合键分别识别高变基因,再取各批次高变基因的交集,用于 PCA 等后续分析。论文给出的 Scanpy 参数为:
min_mean = 0.0125、max_mean = 3、min_disp = 0.5。
这些是论文所用流程中的具体设置,不应视为适用于所有数据集的通用最优参数。
三、整合方法综合比较:到底哪个最好?
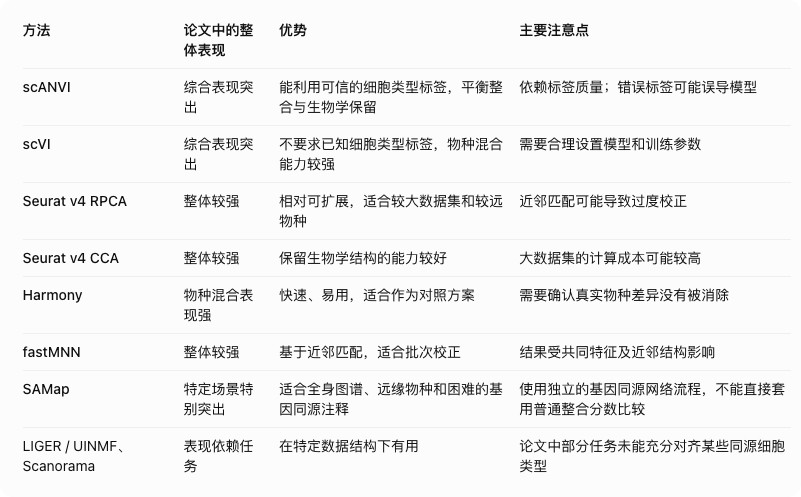
这篇文章对整合算法的总体结论比较明确:scANVI、scVI、Seurat v4 CCA/RPCA、Harmony 和 fastMNN 整体表现较好,但在物种混合和生物学特征保留之间存在权衡。
如果必须选一个综合最好的方法
我的判断是:
有高质量细胞类型标签:优先 scANVI。 这是该论文综合结论中最值得优先测试的方法。
没有可靠的细胞类型标签:优先 scVI。 它是更合适的无监督起点。
希望用成熟的 Seurat 工作流:优先测试 RPCA,同时保留 CCA 作对照。
远缘物种、全身图谱或同源基因注释很差:优先考虑 SAMap,而不是机械地套用 scVI。
以上是根据论文证据给出的实践选择,不代表 scANVI 在任何数据集上都能胜过其他方法。
四、怎么判断哪个方案在你的数据中真正最好?
论文的关键贡献之一,是不只看 UMAP,而是从多个方面评估结果。
1. Species mixing:物种混合
同一类细胞是否能跨物种形成合理的近邻,而不是始终按照物种分成不同群体。可以使用 iLISI、kBET、批次 ASW 等适用指标评估。
2. Biology conservation:生物学保留
整合后,原本不同的细胞类型是否仍能区分,已知细胞亚群和生物学结构是否保留。可以结合细胞类型 ASW、聚类保真度及论文提出的 ALCS 指标进行判断。
3. Annotation transfer:注释迁移
例如,用一个物种已知的细胞类型标签预测另一个物种的细胞类型,检查跨物种预测是否可靠。这能检验整合是否捕捉到了真正可迁移的细胞类型信息。
论文将物种混合和生物学保留的分数按 40% 与 60% 加权,得到 integrated score;同时使用额外的细胞类型可区分性指标来识别过度整合。这个权重是作者用于基准比较的设定,不是所有研究必须采用的唯一标准。
我的建议是:至少比较 scVI、scANVI(若有标签)和 Seurat RPCA 三套方案,并用同一套指标进行评估。 如果物种较远,再增加 SAMap。最终选择应基于你自己的数据表现,而不是单纯依据算法名称或 UMAP 的视觉效果。
五、2025 年之后的研究是否改变了这个结论?
有一些补充。2025 年一项覆盖 20 个物种、约 470 万细胞的基准研究发现,跨越更大的进化距离时,方法的相对表现会发生变化:SATURN 在多个分类层级表现稳健,SAMap 在较远缘物种、特别是全身图谱整合中具有优势;生成模型方法则往往更擅长去除批次效应。
所以,如果你的研究对象不是常见的人–小鼠,而是跨纲、跨门等远缘物种,就不应该只依据 2023 年的结果选方法。那种情况下,我会把 SATURN 和 SAMap 也纳入候选。
六、可复现的实现资源
作者公开了 BENGAL GitHub 仓库,其中包括基因同源映射、整合流程、评估指标和细胞类型注释迁移分析。它接受带有物种信息、细胞类型注释及 Ensembl 基因 ID 的 AnnData 原始计数对象,并提供多种整合算法的结果和评估输出。
- 发表于 1天前
- 阅读 ( 20 )
- 分类:转录组