第一个报错可以修改一下这个代码成这样:mummerCoordsDotPlotly.R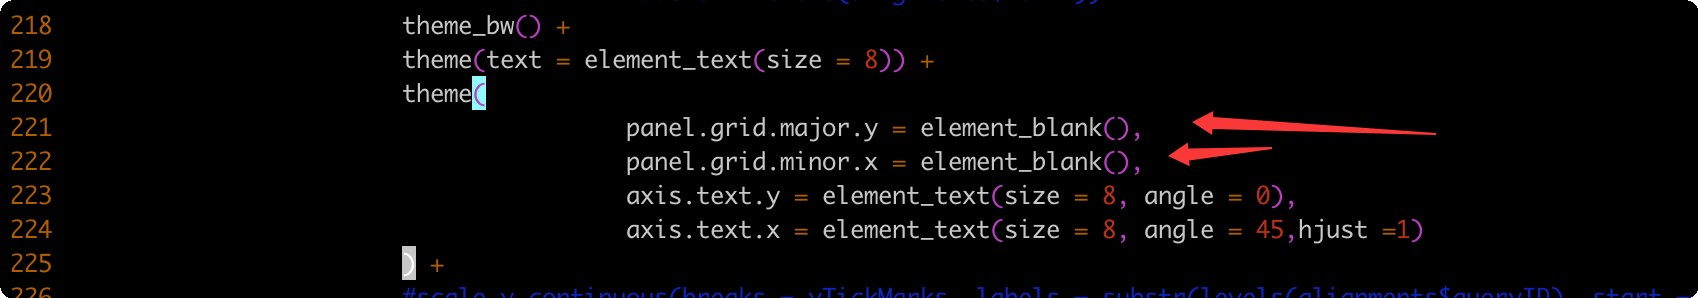
第二个报错:
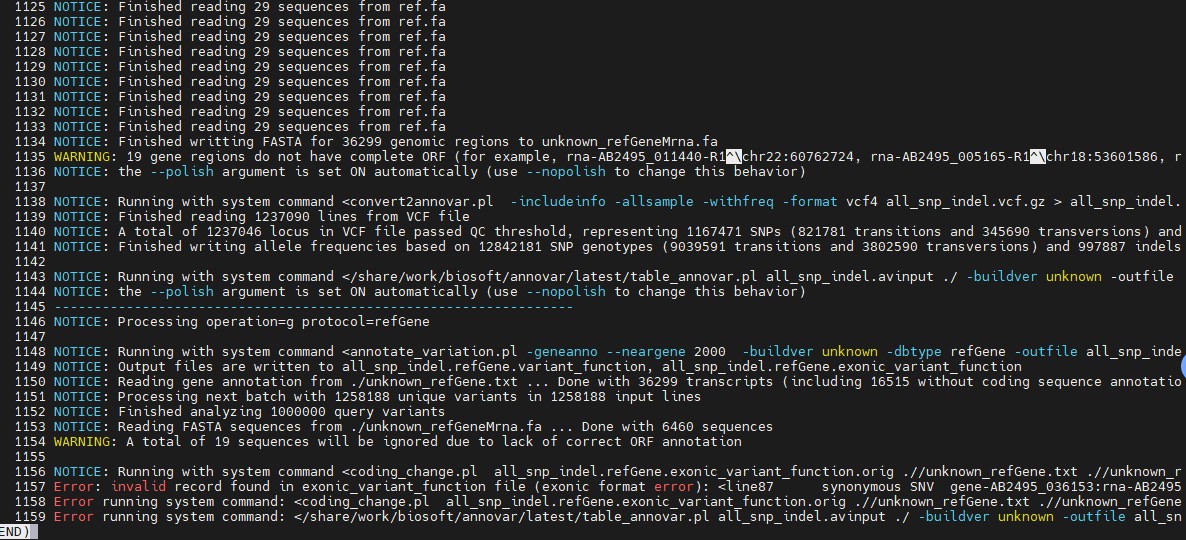
可能某些基因编码有问题,需要调试才能发现问题;
if [ -f "./env.sh" ]; then
source ./env.sh
else
echo "env.sh file not in current directory, please check"
exit
fi
#####################################
cd $workdir
mkdir 04.snp_indel
cd 04.snp_indel
######################################################################
# 1. SNP INDEL 变异 检测
######################################################################
### nucmer 参数说明
# --maxmatch 考虑多处比对
# -c, --mincluster: 用于聚类的匹配最低长度,默认65
# -g, --maxgap: 两个相邻匹配间的最大gap长度,默认90
# -D, --diagdiff: 一个聚类中两个邻接匹配,最大对角差分,默认5
# -l, --minmatch: 单个匹配最小长度 20
# -t, --thread :线程数
## delta-filter 参数 说明
# -i: 最小的相似度 [0,100], 默认0
# -l: 最小的匹配长度 默认0.
# -u: 最小的联配唯一度 [0,100], 默认0
# -o: 最大重叠度,针对-r和-q设置。 [0,100], 默认100
# -g: 1对1全局匹配,不允许重排 -1: 1对1联配,允许重排,是-r和-q的交集
# -m: 多对对联配,允许重排,是-r和-q的合集。
# -q: 仅保留每个query在reference上的最佳位置,允许多条query在reference上重叠
# -r: 仅保留每个reference在query上的最佳位置,允许多条reference在query上重叠
## 其他地方下载的基因组,需要确认染色体一致,添加chr 并只保留chr序列,
#seqkit grep -r -p '^\d+$' $datadir/10.Inn.fa | sed 's/^>/>chr/' > ref.fa
cp $datadir/10_Inn.fa ./ref.fa
for query in 01_Alp 02_Gua 03_Sha 04_Nub 05_Hai 06_Sha 07_Boe 08_Tib 09_Saa 11_Kor 12_ARS;do
#仅仅保留染色体部分比对
seqkit grep -r -p '^chr\d+$' $datadir/$query.fa > $query.fa
## 比对,生成ref_query.delta
#nucmer --maxmatch -g 1000 -c 90 -l 40 -t 2 -p $query ref.fa $query.fa
nucmer -g 1000 -c 90 -l 40 -t 5 -p $query ref.fa $query.fa
## 1-to-1,比对结果过滤及表格生成 -Clr -x 1 -T
delta-filter -1 -r -q -i 90 -l 100 $query.delta > $query.1delta
show-coords -Tclrd $query.1delta > $query.1coords
## 多对多 比对
delta-filter -m -r -q -i 90 -l 100 $query.delta > $query.mdelta
#转换成人类可读的表格格式
show-coords -Tclrd $query.mdelta > $query.mcoords
#比对结果可视化
#Rscript $scriptsdir/mummerCoordsDotPlotly.R -i $query.mcoords -o $query.m -m 1000 -q 300000 -k 30 -s -t -l
#Rscript $scriptsdir/mummerCoordsDotPlotly.R -i $query.1coords -o $query.1 -m 1000 -q 300000 -k 30 -s -t -l
Rscript $scriptsdir/mummerCoordsDotPlotly.R -i $query.mcoords -o $query.m -m 1000 -q 300000 -s -t -l
Rscript $scriptsdir/mummerCoordsDotPlotly.R -i $query.1coords -o $query.1 -m 1000 -q 300000 -s -t -l
#使用 1 对 1 比对结果call SNP和indel
delta2vcf < $query.1delta > $query.snp_indel.vcf
#汇总结果,比对长度与数量
awk 'NR>4{ block ++; sum1 += $5; sum2 += $6; \
}END{print "ref length:\t"sum1"\nqrylength:\t"sum2"\nblocks:\t"block}' \
$query.1coords > $query.1coords.summary
awk 'NR>4{ block ++; sum1 += $5; sum2 += $6; \
}END{print "ref length:\t"sum1"\nqry length:\t"sum2"\nblocks:\t"block}' \
$query.mcoords > $query.mcoords.summary
done
#格式化结果,添加样本名字,并压缩方便后续bcftools合并样本,去除 含有ambiguous的SNP indel ,避免后续ANNOVAR报错
for query in 01_Alp 02_Gua 03_Sha 04_Nub 05_Hai 06_Sha 07_Boe 08_Tib 09_Saa 11_Kor 12_ARS;do
sed "/^#CHROM/s/COUNTS/${query}/" $query.snp_indel.vcf |sed -e '/^##.*GT/s/Integer/String/' -e '/^#/!s#\t0:#\t1/1:#' | awk '$0~/#/ || $4 ~/[ATCG]+/{print $0}'| bgzip >$query.snp_indel.addname.vcf.gz
#sed "/^#CHROM/s/COUNTS/${query}/" $query.snp_indel.vcf |sed -e '/^##.*GT/s/Integer/String/' -e '/^#/!s#\t0:#\t1/1:#' | bgzip >$query.snp_indel.addname.vcf.gz
tabix $query.snp_indel.addname.vcf.gz
done
# 多样本 合并
bcftools merge --threads 2 -m all -o all_snp_indel.vcf `ls *.snp_indel.addname.vcf.gz`
vcftools --vcf all_snp_indel.vcf --recode --recode-INFO-all --stdout --max-missing-count 5 |sed '/^#/!s#\./\.#0/0#g' | bgzip >all_snp_indel.vcf.gz
tabix all_snp_indel.vcf.gz
######################################################################
# 2. ANNOVAR 对变异进行注释
######################################################################
#对变异进行注释,建库
#ATH 参考基因组染色体加上chr,使染色体保持一致
#sed -r '/^[0-9]/s/^/chr/' ../01.prepare_data/Ath.longest_isoform.gff3 >ref.gff
#awk 'BEGIN{OFS="\t"} /^#/{print; next} {a=$1; sub(/^CP/,"",a); sub(/\..*/,"",a); if(a>=168611&&a<=168639){$1="chr"(a-168610)} else if(a==168640){$1="chrX"} else if(a==168641){$1="chrY"} print}' \
#cp ../01.prepare_data/10_Inn.longest_isoform.gff3 ref.gff
##建立ANNOVAR注释需要的库
gffread ref.gff -T -o ref.gtf
gtf=ref.gtf
fa=ref.fa
echo "RUN CMD: gtfToGenePred -genePredExt $gtf unknown_refGene.txt"
gtfToGenePred -genePredExt $gtf unknown_refGene.txt
echo "RUN CMD: retrieve_seq_from_fasta.pl --format refGene --seqfile $fa --outfile unknown_refGeneMrna.fa unknown_refGene.txt"
retrieve_seq_from_fasta.pl --format refGene --seqfile $fa --outfile unknown_refGeneMrna.fa unknown_refGene.txt
#去除非ATCG ,避免ANNOVAR注释报错 :IUPAC:https://www.omicsclass.com/article/409
sed -i '/^[^>]/s/S/G/g' unknown_refGeneMrna.fa
sed -i '/^[^>]/s/K/G/g' unknown_refGeneMrna.fa
sed -i '/^[^>]/s/Y/C/g' unknown_refGeneMrna.fa
## snp indel 注释 ANNOVAR注释结果说明:https://www.omicsclass.com/article/464
table_annovar.pl all_snp_indel.vcf.gz ./ \
-buildver unknown -out all_snp_indel \
-remove -protocol refGene -operation g -nastring . -vcfinput --neargene 2000
后台运行这个脚本的时候,出现了两个错误: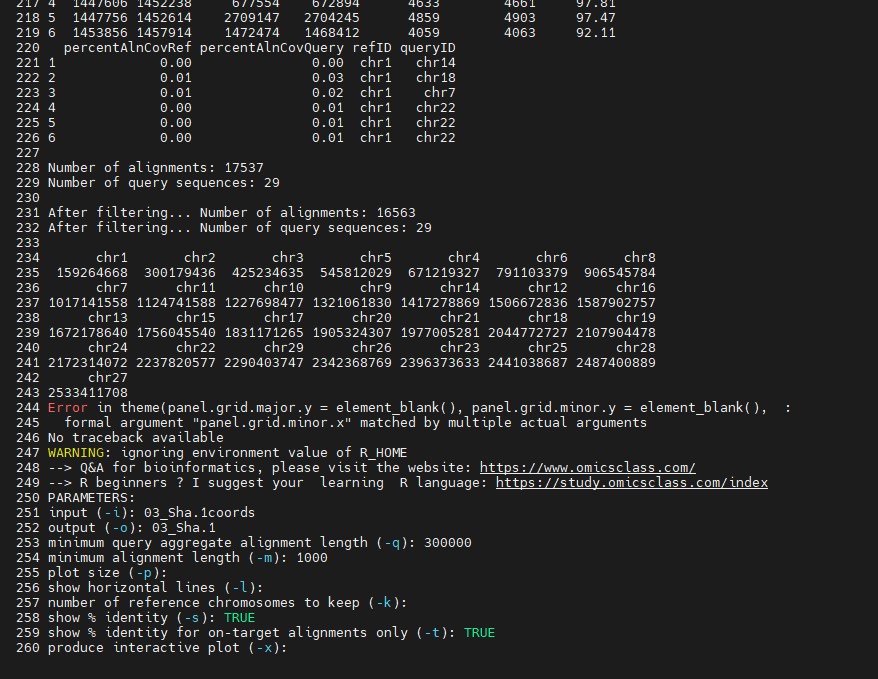
和