基因组染色体和基因GFF朝向更改
基因组染色体和基因GFF朝向更改
做比较基因组或泛基因组分析时,因为是不同的人组装的基因组,多个亲缘相近的物种/个体的染色体的顺序和朝向有时不同,对后续的分析和比较带来很多困难,有些软件甚至可能会报错。这时候我们要找一个大家公认的基因组作为参考,其它基因组作为比较,将同源染色体统一命名,朝向相反的染色体朝向倒转过来,下面给出具体操作命令共大家学习:
# ============================================================
# 1. 将 ref.fa 基因组与query 基因组进行比对查找异常染色体
# ============================================================
# 第一次比对:
# 以 ref.fa.gz 为参考基因组(reference)
# 以 query.fa.gz 为查询基因组(query)
# 使用 minimap2 的 asm5 模式进行组装基因组间比对
# -t 10:使用 10 个线程
# -x asm5:针对序列差异较小的基因组组装比对进行参数优化
# 输出结果为 PAF 格式,保存到 overlaps.paf
minimap2 -t 10 -x asm5 \
ref.fa.gz \
query.fa.gz \
> overlaps.paf
# ============================================================
# 2. 绘制 ref 与 query 基因组的共线性点图
# ============================================================
# 输入 overlaps.paf 比对结果
# 输出以 overlaps 为前缀的点图文件
Rscript pafCoordsDotPlotly2.R \
-i overlaps.paf \
-o overlaps \
-l -s -t \
-k 29 \
-q 10000 \
--no-auto-flip
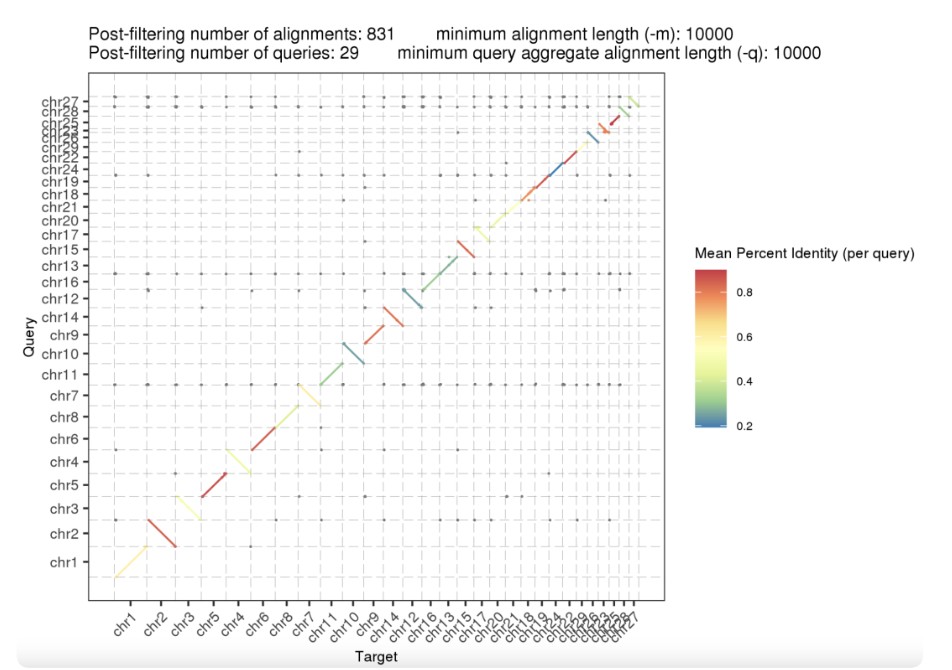
从比对结果图可以发现这些染色体有朝向问题:chr2 chr3 chr4 chr7 chr10 chr12 chr14 chr15 chr17 chr23 chr26 chr27 chr28; 这里需要解释一下这是组装方向约定不同,不是生物学倒位。
下面给出命令将基因组和GFF文件处理一下,倒转相应的染色体及染色体上基因的位置:
# ============================================================
# 1. 提取两个基因组的染色体名称和长度
# ============================================================
# 从 query.fa.gz 中提取序列名称(-n)、序列长度(-l),
# 不输出序列本身(-i),最终生成两列文件:
# 第一列:染色体/序列名称
# 第二列:对应的序列长度
seqkit fx2tab -ni -l query.fa.gz \
| awk -F'\t' '{print $1"\t"$2}' \
> query.chrom.sizes
# ============================================================
# 2. 指定需要反向处理的染色体
# ============================================================
# 这些染色体将进行全长反向操作(forward strand -> reverse strand)。
# 其余染色体保持原方向。
TARGETS="chr2 chr3 chr4 chr7 chr10 chr12 chr14 chr15 chr17 chr23 chr26 chr27 chr28"
# ============================================================
# 3. 生成 chain 文件,用于 GFF 注释坐标转换
# ============================================================
gen_chain() {
  # 输入参数:
  # $1 = 染色体长度文件,例如 query.chrom.sizes
  # $2 = 输出的 chain 文件,例如 query.invert.chain
  local sizes=$1
  local out=$2
  # chain ID 从 1 开始,每条染色体使用一个独立 ID
  local id=1
  # 清空输出文件;如果文件不存在,则创建空文件
  : > "$out"
  # 逐行读取染色体名称和长度
  while read -r name len; do
  # 判断当前染色体是否属于需要反向处理的列表
  if echo " $TARGETS " | grep -q " $name "; then
  # ------------------------------------------------
  # 目标染色体:正向坐标 -> 反向坐标
  # ------------------------------------------------
  # chain 格式:
  # chain score tName tSize tStrand tStart tEnd
  #              qName qSize qStrand qStart qEnd id
  #
  # t = target,目标参考序列
  # q = query,待转换的查询序列
  #
  # 这里将两端都设为同名、同长度的染色体,
  # 目标方向为 +,查询方向为 -。
  # 起止坐标均覆盖整条染色体。
  #
  # 末尾的 len 是 alignment block 的长度;
  # 由于是单个连续 block,因此后面不需要 gap 参数。
  printf 'chain 1000 %s %s + 0 %s %s %s - 0 %s %d\n%s\n\n' \
  "$name" "$len" "$len" \
  "$name" "$len" "$len" \
  "$id" "$len" >> "$out"
  else
    # ------------------------------------------------
  # 非目标染色体:正向坐标 -> 正向坐标
  # ------------------------------------------------
  # 两端方向均为 +,表示全长恒等映射,
  # 染色体名称、长度和坐标方向均保持不变。
  printf 'chain 1000 %s %s + 0 %s %s %s + 0 %s %d\n%s\n\n' \
  "$name" "$len" "$len" \
  "$name" "$len" "$len" \
  "$id" "$len" >> "$out"
  fi
  # 处理下一条染色体时,chain ID 加 1
  id=$((id+1))
  done < "$sizes"
}
# 分别为两个基因组生成 chain 文件
gen_chain query.chrom.sizes query.invert.chain
# ============================================================
# 4. 检查生成的 chain 文件
# ============================================================
# 查看 query.invert.chain 的前 6 行,
# 检查 chain 头部和 alignment block 是否符合预期
head -6 query.invert.chain
# 统计 chain 文件中的映射区块数量
# 如果每条染色体对应一条 chain,且基因组有 29 条序列,
# 那么这里预期输出 29
grep -c '^chain' query.invert.chain
# ============================================================
# 5. 准备未压缩的参考基因组 FASTA 和索引
# ============================================================
# 解压基因组 FASTA,保留原始 .fa.gz 文件
zcat query.fa.gz > query.fa
# 建立 FASTA 的 .fai 索引,供 CrossMap 和 samtools faidx 使用
samtools faidx query.fa
# ============================================================
# 6. 使用 CrossMap 转换 GFF 注释坐标
# ============================================================
# 转换 Kor 基因组的 GFF 注释
# 输入:
#   query.invert.chain:坐标映射关系
#   query.gff.gz:原始 GFF 注释
# 输出:
#   query.inverted.gff:转换后的 GFF 注释
#
# --chromid a:按照 CrossMap 对应版本的参数约定,
#              处理染色体 ID 的匹配方式;请结合当前版本文档确认。
CrossMap gff --chromid a \
query.invert.chain \
query.gff.gz \
query.inverted.gff
# ============================================================
# 7. 生成反向处理后的基因组 FASTA
# ============================================================
rc_genome() {
  # 输入参数:
  # $1 = 原始 FASTA 文件
  # $2 = 输出 FASTA 文件
  local fa=$1
  local out=$2
  # 清空输出文件,避免将结果追加到旧文件中
  : > "$out"
  # 从 .fai 索引中逐条读取序列名称
  # 保持原始 FASTA 的染色体排列顺序
  for name in $(cut -f1 "${fa}.fai"); do
  # 判断当前序列是否属于目标染色体
  if echo " $TARGETS " | grep -q " $name "; then
  # 对目标染色体进行反向互补:
  # -r:反转序列方向
  # -p:输出反向互补序列
  # --seq-type DNA:指定 DNA 序列类型
  #
  # samtools faidx 按染色体名称提取整条序列,
  # seqkit seq 再将其反向互补并写入输出文件。
  samtools faidx "$fa" "$name" \
  | seqkit seq -r -p --seq-type DNA >> "$out"
  else
    # 非目标染色体直接提取并写入,
    # 保持序列方向和碱基内容不变
    samtools faidx "$fa" "$name" >> "$out"
  fi
  done
}
# 分别生成两个基因组的反向处理后 FASTA
rc_genome query.fa query.inverted.fa
# ============================================================
# 8. 使用 pigz 并行压缩输出文件
# ============================================================
# 将两个基因组的输出 FASTA 和转换后的 GFF 文件压缩。
# 默认情况下,pigz 会生成对应的 .gz 文件。
pigz *inverted.fa *inverted.gff
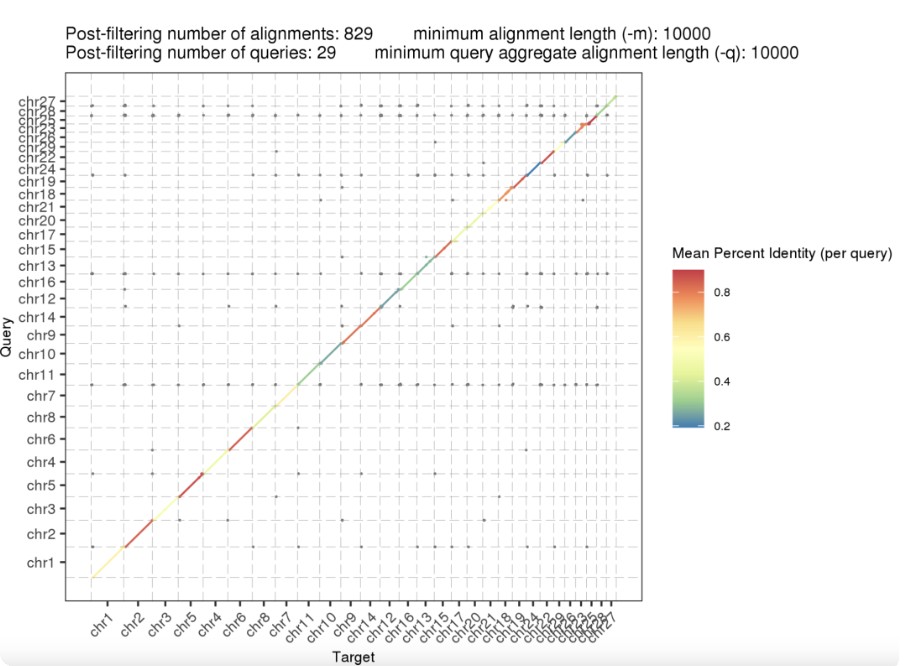
倒转后基因组结果图:
如果要验证倒转的基因位置是否正确可以使用JCVI做基因的共线性分析,见比较基因组课程:
- 发表于 2026-10-20 16:40
- 阅读 ( 198 )
- 分类:基因组学


